Déploiement : matériel, contexte d'exécution, communication
Un deployment indique où s'exécutent les parts d'un système : sur quel
processeur, dans quel programme, sur quel thread. archec le vérifie, prédit ses
temps de réponse et peut le suivre pendant l'exécution. Un même système peut
avoir plusieurs déploiements.
Un premier déploiement#
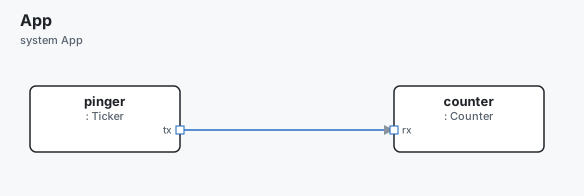
Deux parts : pinger envoie PING toutes les 5 ms, counter le reçoit. Les
deux tournent sur un seul microcontrôleur.
message PING { n: uint16; period 5ms }

component Ticker {
  out tx: data sends PING
  fn tick { wcet 1ms }
}

component Counter {
  in rx: data receives PING { depth 8 }
  fn count { wcet 200us }
}

component Mcu {
  kind processor
  compute { cores 1; os freertos }
}

system App {
  part pinger:  Ticker
  part counter: Counter
  pinger.tx -> counter.rx
}

system Board {
  part mcu: Mcu
}

deployment D {
  system App
  platform Board
  binary fw on mcu {
    thread fast { runs pinger; period 5ms; step tick; priority 2 }
    thread slow { runs counter; priority 1; queue 8 }
  }
  chain ping { through pinger, counter; budget 10ms }
}
Lisez-le de haut en bas :
Appest le système logique : il dit quelles sont les parts.Boardest la plateforme : le matériel.Mcuest un processeur à un cœur, sous FreeRTOS.Dplace le programmefwsur le processeur. Il a deux threads.fastexécutepingertoutes les 5 ms et appelle sontick.slowexécutecounterà l'arrivée d'un message.wcetest le temps d'exécution au pire cas d'une fonction. L'analyse temporelle part de cette valeur.- Une
chainest un chemin à travers les parts, avec un budget de temps de bout en bout.
Vérifiez-le et demandez son analyse temporelle :
archec check main.arche
archec analyze main.arche
✓ no errors
Deployment D
Threads
thread where prio C T D R
fast mcu/cpu0 2 1ms 5ms 5ms 1ms ok
slow mcu/cpu0 1 200us 5ms 5ms 1.2ms ok
Cores
mcu/cpu0 24 % (RM bound 82.8 %) fast, slow
Chain ping
pinger fast wait ≤ 5ms run 1ms → 0ns (same-process)
counter slow wait ≤ 0ns run 1.2ms
worst case 7.2ms — budget 10ms okC est le temps d'exécution, T la période, D l'échéance et R le temps de réponse
au pire cas. archec analyze sort avec le code 1 quand un cœur est surchargé,
ou quand une échéance ou le budget d'une chaîne peut être dépassé.
Trois questions séparées#
Le modèle logique (un system) dit quelles sont les parts. Trois autres
questions en sont séparées, pour qu'un même système puisse être déployé de
plusieurs façons.
Le matériel : où les choses s'exécutent.
- Un processeur est un composant doté de cœurs (
cores 8,core safety { type "Cortex-R52" }), d'unoset deram. - Un bus est un composant avec
kind buset unbitrate. - Placez-les dans un
systemde plateforme.
Le contexte d'exécution : ce qui s'exécute.
- Un
deploymentplace desbinary(des programmes) sur des processeurs. - Un binaire contient des
process. Un processus est un espace d'adressage. Il n'y a pas de processus sur un RTOS. - Les processus contiennent des
threadet desisr(gestionnaires d'interruption). Chacun acceptepriority,period,deadline,coreetstack. - Un thread exécute des parts (
runs). Leurs fonctions, leurs handlers et leur machine à états s'exécutent sur ce thread, un à la fois.
La communication : comment deux parts échangent, sur les ports et les liens.
patterndit qui attend et combien reçoivent :fire-and-forget(par défaut),request-reply,pub-suboubroadcast.bufferdit ce que garde le récepteur :queue(avecdepthetoverflow),sampleoustream.timeout,deadline,stale-after,reliabilityettopicles complètent.
Un déploiement plus grand, sur deux processeurs et un bus CAN :
deployment Vehicle "L4 stack on the vehicle" {
  system Car                        // what runs
  platform CarHw                    // where

  binary adas "adas-stack" on adcu_soc {
    process driving { core cpu2; thread drive { runs adcu; priority 80 } }
  }
  binary brake_fw "brake.elf" on brake_mcu {      // FreeRTOS: tasks, no process
    thread ctl { runs brakes; period 1ms; step regulate; priority 10 }
  }
  route adcu.can_brake -> brakes.can over chassis_can { priority 3 }
  chain obstacle { through adcu, brakes; budget 100ms }
}
L'exemple complet se trouve dans examples/autonomous-car/deployment.arche.
Comment un lien est transporté#
Le transport de chaque lien découle de l'endroit où s'exécutent ses deux extrémités :
- sur le même thread ;
- dans le même processus ;
- sur le même processeur, avec la latence
ipc-latencydu processeur ; - sur un autre processeur, par la
routedu lien sur un bus.
Un lien entre deux processeurs sans route est une erreur.
Ce que signale le linter#
- une part dotée d'un comportement qui ne s'exécute nulle part ;
- un cœur que le processeur n'a pas ;
- un bus qui ne relie pas les deux processeurs ;
- des patterns qui ne correspondent pas aux deux extrémités ;
- une requête sans handler pour la traiter ;
- une file non bornée sur un RTOS ;
- des niveaux de sûreté mélangés dans un même espace d'adressage.
Ce que calcule archec analyze#
archec analyze (et l'éditeur) calcule :
- la charge de chaque cœur et les temps de réponse à priorités fixes, à partir
de
wcet,periodetpriority; - la charge de chaque bus, à partir de la taille et de la période des messages ;
- la latence au pire cas de chaque
chain, comparée à son budget.
Temps mesurés#
Vous pouvez ensuite mesurer ce que fait vraiment le système et le comparer à la prédiction.
archec gen --target c --trace(ou--target embassy --trace) insère des points de trace dans le code généré. Ils enregistrent l'activation et la fin de chaque thread, les messages, les trames de bus et les chaînes.- Exécutez le programme. Il écrit une trace.
archec timing main.arche <trace…>lit les traces, ou tout JSON au format Chrome trace. Pour chaque thread, il affiche la période, la gigue et le temps de réponse. Il affiche aussi la charge de chaque cœur, celle de chaque bus et la latence de chaque chaîne, à côté de la prédiction.
Un résultat pire que prévu signifie que l'analyse est optimiste : un wcet est
trop petit. Dépasser une échéance ou un budget est un échec. Voir
examples/timing, et examples/greenhouse pour une trace venue d'une carte
(ou de Renode) par son UART.
Compilé en mode live (make LIVE=1, ou -DARCHE_TRACE_LIVE), le C écrit
chaque ligne de trace sur stdout au fil de l'eau. Parmi ces lignes figure l'état
dans lequel entre la machine de chaque part, par exemple
arche-trace <ns> state counter.Seen 0. On peut alors suivre un système en
cours d'exécution (voir Live).
Exécution et mémoire#
Un thread est un objet actif : il exécute ses parts un message à la fois, en puisant dans sa file.
queue 32dimensionne cette file. Sur un RTOS, un thread réveillé par des messages doit l'indiquer.affinity cpu1, cpu2donne les cœurs sur lesquels le thread peut tourner, quand un seulcorene suffit pas à le dire.- Un thread peut aussi exécuter un seul port d'une part.
runs sink.metricstraite les messages de ce port sur ce thread, et non sur le thread de la part.
Une part qu'aucun thread n'exécute peut quand même s'exécuter : placez-la
(place) dans un processus. Elle est alors :
passive: elle s'exécute dans les threads de ses appelants ;- ou
protected: elle s'exécute dans les threads de ses appelants, un appelant à la fois.
execution active indique que la part a besoin de son propre thread.
La mémoire provient d'allocateurs.
- Un processeur déclare ses mémoires :
memory ddr { size 1GiB; shared }(unememorysans type ni adresse). - Un
allocatordans le déploiement, un binaire ou un processus prend ses blocs dans l'une de ces mémoires, ou dans un allocateurparent. - Un
placeindique ensuite d'où vient la mémoire d'une part, pour chaque usage :hrt: ses données temps réel ;lrt: le reste ;savedettmp: la mémoire de travail d'un algorithme ;comm: ce que ses ports sérialisent.
- Le
bufferingd'un port de flux de données indique la taille de ses buffers, si les consommateurs les copient ou les partagent, quand ils sont libérés et d'où ils viennent.
deployment Target {
  allocator heap { kind heap; block-size 1MiB; memory cpu.ddr; shared }
  binary chain on cpu {
    options mygen { orb "rteorb" }
    process main {
      allocator frames { kind pool; block-size 4KiB; blocks 32; parent heap; alignment 64 }
      thread work { runs chain; priority 50; queue 32; affinity cpu1, cpu2 }
      thread watch { runs sink.metrics; queue 8 }
      place log { execution protected; memory hrt frames }
      place chain.f1 { memory saved frames; memory tmp frames }
      place chain.split.input {
        memory comm frames
        buffering { max-size 4KiB; transfer copy; destroy after-processing; allocator frames }
      }
    }
  }
}
Le linter signale :
- une part active qu'aucun thread n'exécute, et une part passive qu'un thread exécute ;
- un thread qui exécute un port de sortie ;
- un allocateur appartenant à un autre processus ;
- un allocateur dans une mémoire locale qui est
mapped; - les débordements : un allocateur enfant plus grand qu'un bloc de son parent, plus d'usages que de blocs, un buffer plus grand qu'un bloc, des allocateurs plus grands que leur mémoire.
Un buffer partagé et libéré dès son envoi est une erreur : ses consommateurs liraient de la mémoire libérée.
options <generator> { … } sur un binaire (ou un processus) fixe les options de
ce générateur pour lui seul, par-dessus celles du projet. options { … } les
fixe pour tous les générateurs. Le modèle du générateur donne à chaque binaire
et à chaque processus ses options résolues. Voir examples/signal-chain.
Live#
archec live main.arche lance les conteneurs d'un déploiement et affiche l'état
du modèle pendant leur exécution.
- Il exécute les conteneurs sous podman. Le C généré est tracé en direct
(
--target containerd). - Il suit leurs logs et
podman stats. - Chaque exigence, chaîne, thread et conteneur est
pass,failoupending.
Ce qui fait échouer quoi :
- Une chaîne qui dépasse son budget fait échouer l'exigence qu'elle satisfait
(
satisfies). - Un thread en retard, ou un conteneur qui dépasse sa
memory-limit, fait échouer ce que ses parts satisfont. - La ligne
arche-trace <ns> monitor REQ-1 1d'un moniteur d'exécution fait échouer REQ-1.
Options :
--jsondiffuse l'état, un JSON par ligne, chaque élément avec son fichier et sa ligne. L'éditeur le lit.--once --duration 30ssert de garde-fou en CI.--replay trace.logévalue des traces déjà écrites.
Conteneurs#
Un container contient des binaires, au lieu de les placer directement sur le
processeur. Il lui faut un processeur Linux dont le compute indique runtime containerd. L'image du conteneur porte le nom de son identifiant. Ses binaires
reprennent son on.
Il déclare aussi son cgroup et son bac à sable :
- les cœurs qu'il peut utiliser (
core, son cpuset) ; memory-limit;network host,bridgeounone;- les
devicede l'hôte qu'il voit (/dev/ttyS1) ; - les
capabilitiesLinux :sys_nicepour les threads enpolicy fifo,allpour un conteneur privilégié ; - des variables d'environnement (
prop NAME = "value").
container driving "registry.local/l4/driving:0.3" on adcu_soc {
  core cpu2, cpu3, cpu4, cpu5; memory-limit 4GiB; network host
  capabilities sys_nice; prop RUST_LOG = "info"
  binary adas { language rust; thread drive { runs adcu; core cpu2; priority 80; policy fifo } }
}
Un conteneur doté d'une memory-limit compte une seule fois dans la ram de
son processeur. Ses processus sont vérifiés par rapport à cette limite. Un lien
entre deux conteneurs coûte la ipc-latency du processeur. Quand l'un d'eux est
sur un réseau bridge, il coûte la latency de ce conteneur.
Le linter signale :
- un conteneur sur un processeur non Linux, ou sur un processeur sans runtime ;
- un thread hors des cœurs de son conteneur ;
- un thread temps réel sans
sys_nice; - un lien qui sort d'un conteneur
network none; - un conteneur sur un bus CAN sans
network host(lecan0de SocketCAN est une interface réseau, pas un périphérique) ; - un conteneur sur un autre bus (une ligne série) qui ne voit aucun périphérique ;
- un binaire dans un conteneur qui déclare aussi
on.
archec gen --target containerd écrit les images et les fichiers compose.
--target k8s écrit les manifestes Kubernetes (k3s) qui les exécutent, chacun
épinglé au nœud de son processeur (voir Génération de code).
Un conteneur par processus#
packaging container met chaque processus dans son propre conteneur, sans avoir
à les écrire un par un. Chaque processus d'un binaire sur un processeur Linux
reçoit un conteneur :
- nommé d'après le processus, sur ce processeur ;
- avec le ou les cœurs du processus comme cpuset, et sa
memory-limit; - sur le réseau de l'hôte ;
- avec
sys_nicequand l'un de ses threads est temps réel.
Les threads d'un binaire qui ne sont dans aucun processus partagent un conteneur, nommé d'après le binaire. Les conteneurs que vous écrivez vous-même restent tels quels : écrivez-en un explicitement pour lui donner une image, un périphérique ou un autre réseau.
deployment Vehicle {
  packaging container
  binary adas on adcu_soc {
    process driving { core cpu2; memory-limit 4GiB; thread drive { runs adcu; policy fifo } }
    process island { core safety; thread guard { runs adcu.brakes_path } }
  }
}
Dans le projet Arche#
Les conteneurs du déploiement simulé vont dans containers.yaml : processeur,
cores du cpuset, memoryLimit, network, latency, image, périphériques,
capabilities et env. Un processus dans un conteneur, ou un thread sans
processus, indique container: <id> et garde sa propre cible et son propre
cœur. La page Hardware d'Arche regroupe les threads de chaque cœur par
conteneur.
Limites#
- L'analyse temporelle part du
wcetque vous écrivez. Elle ne le mesure pas : unwcettrop petit donne une prédiction optimiste. Comparez avec une trace mesurée (archec timing). archec liven'exécute les conteneurs qu'avec podman.- Les conteneurs exigent un processeur Linux avec
runtime containerd. - La simulation d'Arche exécute les threads d'un conteneur comme n'importe quel autre thread. Le conteneur ne les regroupe que sur la page Hardware.