Notes de conception
Cette page explique pourquoi le langage est tel qu'il est. Elle couvre les choix derrière la syntaxe, le fonctionnement des pointeurs et les performances d'archec. Lisez-la quand vous vous demandez pourquoi une chose s'écrit d'une façon plutôt que d'une autre.
Une seule écriture pour chaque chose#
Chaque chose a une écriture standard, et une seule. Les anciennes écritures
sont toujours acceptées, et archec vet les signale. Enregistrez ceci sous
old.arche :
message PING "Ping" { field seq: uint8 }

component Sensor "Sensor" {
  port data "Data": data out
  states {
    initial Idle
    state Idle
  }
}

component Logger "Logger" {
  in data: data receives [PING]
}

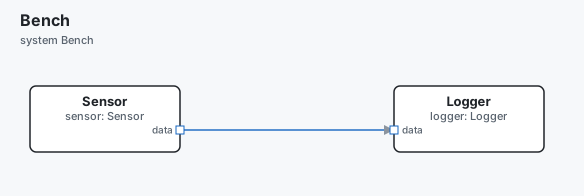
system Bench "Bench" {
  part sensor: Sensor
  part logger: Logger
  sensor.data -> logger.data
}
archec vet old.archeold.arche:4:3 hint Short form: `out data: data "Data"` — the direction is the keyword [long-form]
old.arche:7:5 hint `initial Idle` says nothing: a state machine starts in its first state [long-form]
old.arche:13:26 hint Short form: `receives PING` [long-form]
3 style finding(s) — `archec fmt --write` fixes the layout onesarchec fmt --simplify --write old.arche réécrit le fichier avec les formes
courtes (out data: data "Data", pas de initial, receives PING). Le projet
Arche qu'écrit archec build reste identique à l'octet près.
Parmi les anciennes écritures :
port x "N": t outetout x "N": t;body ```…```;- les listes entre crochets,
[A, B]; initial X;: type { carries [M] };main "…"etdo "…";- deux propriétés sur une même ligne sans
;.
Chacune donne une indication long-form ou same-line, avec une correction
rapide dans l'éditeur.
Pointeurs#
*T est un pointeur vers un T. La forme C T* fonctionne aussi, de même que
**T, *void et les tableaux de pointeurs (*T[4]). Un type pointeur
s'utilise partout où un type est accepté : variables, champs de struct et de
message, arguments et résultats de fonction, constantes, blocs mémoire.
- Un pointeur occupe
pointer-sizeoctets :project { pointer-size 8 }. La valeur par défaut est 4. - Il contient une adresse : un entier, une constante ou
nil. Toute autre valeur est une erreur (pointer-value). - Arche n'a pas de type pointeur. Chaque type pointeur devient donc une entrée
du catalogue dans
data-types.yaml. Par exemple,ptr_Node, nommé*Node, est un entier non signé de la largeur d'une adresse, d'unitéaddress. - Dans le diagramme de classes, un champ pointeur vers une structure est une
association. - Un pointeur dans la charge utile d'un message est signalé (
pointer-on-wire) : une adresse n'a aucun sens pour le destinataire.
Les choix du langage#
Mots-clés contextuels. L'analyseur lexical ne produit que des identifiants. Le sens vient de la position :
state,typeouportrestent donc utilisables comme noms.Propriétés sensibles aux lignes. Les valeurs d'une propriété commencent sur sa propre ligne (
priority high). Après une virgule, elles peuvent continuer à la ligne suivante.- Les propriétés peuvent donc s'écrire une par ligne, sans séparateur. Sur
une même ligne,
;les sépare. - Le formateur ne fait donc que réindenter : il ne déplace jamais un token.
- Seule exception : un bloc
ouvert en fin d'en-tête (`fn fpython`) voit son corps indenté d'un niveau sous cet en-tête. Le code ne change pas, car l'indentation commune d'un bloc est retirée à la lecture.
- Les propriétés peuvent donc s'écrire une par ligne, sans séparateur. Sur
une même ligne,
Du Python là où va du Python. Certains endroits acceptent du Python tel quel, jusqu'à la fin de la ligne :
do,expectetsetupdans les plans de test,dodans les stimuli, et l'/ actiond'une transition. Les parenthèses doivent être équilibrées ; un;ou le}du bloc termine le code. Vous n'écrivez ni guillemets ni échappements\", et le linter peut lire les noms.Les identifiants peuvent contenir
-(REQ-BRK-001,can-fd), comme les id d'Arche. Écrivez la soustraction avec des espaces :a - b. SiMAXest une constante et queMAX-1ne désigne rien, le linter signalehyphen-minus, avec la correctionMAX - 1.La structure séparée de la mise en page.
canvas System { … }contient les positions sur le canevas. Le système se lit donc comme ce qui est relié à quoi, et déplacer un bloc sur le canevas ne le modifie pas.Une seule table décrit le langage (
src/spec.ts). Les contextes du parseur, les vérifications de propriétés du linter, la complétion, le survol etdocs/patterns.mden découlent tous.Une seule façon d'écrire chaque chose (
src/canonical.ts).- Chaque déclaration a un seul mot-clé standard.
- Les mots-clés de plusieurs mots prennent un trait d'union :
port-type,test-plan,use-case,failure-mode. - Un mot veut dire une seule chose.
busn'est pas un type de port : un bus est un composant aveckind bus.processest un processus de l'OS dans un déploiement ; un flux de travail est unworkflow.modeest unoperating-mode, pas un état. - Un pseudo-état s'écrit
pseudo choice;kindest réservé au catalogue. - La provenance d'une exigence est
origin;sourceindique où se trouve le code. - Les champs s'écrivent
attr key = value, commeprop key = value. - Une fonction privée s'écrit
private fn. extendsse place dans l'en-tête.- Les listes n'ont pas de crochets.
- Les valeurs sont en minuscules (
complexity medium). - Une unité s'écrit telle quelle (
unit m/s²,unit °C). On ne la met entre guillemets que si elle contient un espace. processoretdevicedeviennentcomponent. Ce qui fait d'un bloc du matériel, c'estkind processor(oucores).
Les anciennes écritures sont toujours lues, et produisent le même projet. Chacune donne une indication
alias-keyword, etarchec fmt --simplifyla réécrit.
Performances#
node tools/bench/bench.js mesure archec sur deux modèles :
- un vrai projet de 69 fichiers (1,7 Mo), lu dans le dossier indiqué par
ANTENNA_DIR; - un modèle dix fois plus gros (681 fichiers, 17 Mo), produit à partir du
premier par
tools/bench/synth.js: le projet plus neuf copies où chaque déclaration est renommée.
Il mesure le chargement, la vérification et l'émission dans un même processus ;
archec check et archec build en tant que commandes ; et le serveur de
langage sur stdio.
Le tableau est en ms, sur un Apple M4 Max qui exécutait d'autres tâches. Les chiffres varient de 10 à 20 % d'une exécution à l'autre. « Avant » correspond au commit 76ea8f2, antérieur à ce travail.
| 1× avant | 1× après | 10× avant | 10× après | |
|---|---|---|---|---|
| chargement + vérification, à chaud | 230 | 122 | 3024 | 1248 |
| modification d'un fichier, nouvelle vérification (fin du fichier / milieu) | 230 | 55 / 70 | 3133 | 541 / 664 |
| compilation complète (émission, schéma, règles), à chaud | 401 | 277 | 7762 | 5651 |
archec check |
750 | 621 | 8407 | 6204 |
archec build |
1316 | 759 | 12495 | 7136 |
| éditeur : ouverture → premiers diagnostics | 725 | 302 | 8124 | 1733 |
| éditeur : frappe → diagnostics | 449 | 174 | 3197 | 831 |
Ce qui a fait la différence :
- Du travail qui croissait plus vite que le modèle. Quatre opérations
étaient lentes sur un gros modèle. La vérification est maintenant 2,5 fois
plus rapide sur le modèle 10×, et le chargement 2 fois plus rapide.
- Les ports qui fournissent une interface étaient trouvés en parcourant tout le modèle, une fois par interface.
- Les formes longues analysaient chaque fichier une seconde fois.
- Les
defaultsétaient recherchés pour chaque nœud. - L'analyseur lexical testait chaque caractère avec une expression régulière.
- Une compilation incrémentale (
src/incremental.ts,Session).- La vérification s'exécute par morceaux : chaque déclaration de premier niveau, et les formes longues de chaque fichier.
- archec enregistre ce que lit chaque morceau : les noms recherchés et leur résultat, les déclarations atteintes, les fichiers consultés et les espaces de noms listés.
- Après une modification, un morceau n'est pas réexécuté si sa propre déclaration et tout ce qu'il a lu sont inchangés. Ses diagnostics et ses références sont réutilisés, à leur place.
- Certaines modifications changent ce que fait le chargement d'un fichier à l'autre : les inclusions, un package, le projet, les traductions, les means, les génériques ou un fichier .py. Après celles-ci, tout est revérifié.
- Les tokens des fichiers inchangés sont eux aussi conservés.
test/incremental.test.jsle vérifie. Après des modifications aléatoires d'un seul fichier sur chaque exemple, il compare le résultat à une compilation depuis zéro. Les diagnostics doivent être les mêmes, dans le même ordre, et le projet identique à l'octet près.ARCHE_INC_SEEDS=150exécute 22 000 modifications.
- Le serveur de langage.
- Il compile chaque projet avec une Session.
- Il ne relit un fichier sur le disque que si sa taille ou sa date change.
- Il répond à « qu'y a-t-il ici », aux références, au renommage, aux symboles et aux couleurs sémantiques à partir d'un index de chaque programme.
- Il exécute la compilation complète (émission, schéma, règles) dans un thread worker : la vérification d'une frappe ne l'attend jamais.
- La pause avant la vérification d'une frappe suit la durée de la dernière vérification (50 à 200 ms).
- Le moteur de règles d'Arche. Il est embarqué dans
vendor/arche.js, etarchec checkainsi que la compilation complète l'exécutent. Il copiait toutes les constantes du projet dans la portée de chaque sujet, pour chaque règle. Il comptait aussi les traces de chaque élément en les parcourant toutes. Désormais, il recherche les constantes et compte les traces une seule fois (arche/frontend/src/rules.ts).archec checksur le modèle 10× est passé de 6,7 s à 3,4 s, avec une sortie identique à l'octet près.
Limites#
- Le chargement (environ 250 ms sur le modèle 10×) et les vérifications du projet entier (environ 150 ms) s'exécutent encore en totalité à chaque modification.
- La CLI n'a pas de cache disque. L'essentiel de son temps part dans l'émission, qu'une modification change de toute façon.